-
[가상 면접 사례로 배우는 생성형 AI 서비스 설계] 3장: 구글 번역기 (Google Translate)스터디 2026. 8. 29. 17:31
1. 요구사항 구체화 (Clarify Requirements)
📌 기능적 요구사항
- 다국어 텍스트 번역: 소스 언어 문장을 지정된 타깃 언어 문장으로 정확하게 번역.
- 다중 언어 지원: 영어, 스페인어, 한국어, 프랑스어 4가지 언어를 우선 지원하며 추후 확장.
- 언어 자동 감지: 입력 텍스트의 언어를 자동으로 감지하는 기능 제공.
📌 제약사항
- 입력 길이 제한: 1회 요청당 최대 1,000개 단어 지원.
2. 머신러닝 관점의 문제 정의 (Problem Formulation)
📌 입력과 출력 구체화
- 입력(Input): 원본 문장, 번역 목표 언어
- 출력(Output): 번역된 문장
📌 머신러닝 방법: 인코더-디코더 트랜스포머
- 시퀀스 투 시퀀스(Seq2Seq):
- 인코더: 입력 시퀀스를 처리하고 컨텍스트 벡터로 변환하여 입력 시퀀스의 정보를 인코딩.
- 디코더: 인코더의 컨텍스트 벡터를 활용하여 한 번에 토큰 하나씩 출력 시퀀스를 생성.
- 인코더-디코더 트랜스포머의 특장점:
- 독립적 역할 분리: 입력을 이해하는 것과 출력을 생성하는 것이 분리되어 있어, 인코더를 원본 언어 특성에 특화되게 설계 가능.
- 가변 길이 시퀀스 처리: 원문과 번역문의 길이가 달라도 구조적으로 자연스럽게 대응.
- 교차 어텐션 메커니즘(Cross-Attention): 생성 중 디코더가 입력 시퀀스의 중요한 부분을 그때그때 다이나믹하게 참조.
3. 데이터 준비 및 전처리 (Data Preparation)
일반 데이터와 번역 데이터 모두 노이즈가 있으므로 전처리 후 토큰화한다.
📌 텍스트 전처리
- 누락 데이터 제거: 비어있거나 불완전한 문장 쌍 제거.
- 노이즈가 있는 데이터 제거: 잘못 정렬되거나 깨진 문자, 노이즈 텍스트 필터링.
- 중복 제거: 동일한 문장 쌍의 중복 수집 데이터 제거.
- 개체명 처리(Named Entity Handling): 고유명사, 브랜드명, 특수 표기 등이 번역 과정에서 변형되지 않도록 사전 처리.
📌 텍스트 토큰화
- BPE (Byte Pair Encoding): 서브워드(Subword) 분할 알고리즘을 활용하여 어휘 사전(Vocabulary) 크기를 최적화하고 OOV(Out-Of-Vocabulary) 문제 해결.
더보기1. BPE가 등장한 이유 (기존 토큰화의 한계)
- 단어 단위 토큰화 (Word-based)
- "learn", "learning", "learned"를 모두 별개의 단어로 취급합니다.
- 어휘 사전(Vocabulary)의 크기가 너무 커지고, 사전에 없는 단어가 나오면 OOV(Out-Of-Vocabulary, 미등록 단어) 문제가 발생하여 [UNK](Unknown) 토큰으로 처리되어 의미를 잃게 됩니다.
- 문자 단위 토큰화 (Character-based)
- 모든 글자를 자음/모음 또는 알파벳 단위로 쪼개므로 OOV 문제는 없어집니다.
- 하지만 시퀀스 길이가 너무 길어져 모델의 연산량이 급증하고, 단어 자체의 의미 정보가 희석됩니다.
👉 해결책: 단어를 더 작은 의미 단위인 서브워드(하위 단어)로 쪼개는 BPE를 도입하여 두 방식의 장점을 모두 취했습니다. (예: unfriendly -> un + friend + ly)
2. BPE의 핵심 동작 원리
BPE는 원래 데이터 압축 알고리즘에서 유래했습니다. 텍스트에서 가장 자주 등장하는 연속된 문자 쌍(Pair)을 하나의 문자/토큰으로 병합(Merge)하는 과정을 반복합니다.
🔄 학습(Training) 과정 단계별 예시
다음과 같은 단어 빈도수 데이터셋이 있다고 가정해 보겠습니다.
- low : 5회, lower : 2회, newest : 6회, widest : 3회
1단계: 모든 단어를 글자(Character) 단위로 분할하고 어휘 사전 초기화
- 초기 어휘 사전: {l, o, w, e, r, n, s, t, i, d}
- 초기 데이터:
- l o w : 5
- l o w e r : 2
- n e w e s t : 6
- w i d e s t : 3
2단계: 가장 빈도수가 높은 연속된 문자 쌍(Pair) 찾기
- 문자 쌍 빈도 계산:
- e + s -> 6회 (newest), 3회 (widest) = 총 9회 (최다 빈도)
3단계: 최다 빈도 문자 쌍을 병합(Merge)하여 사전에 추가
- e와 s를 es로 병합.
- 어휘 사전에 es 추가.
- 데이터 업데이트:
- n e w es t : 6
- w i d es t : 3
4단계: 다음 최다 빈도 문자 쌍 병합 반복
- 그 다음으로 es + t가 총 9회 등장하므로 est로 병합.
- 어휘 사전에 est 추가.
- 데이터 업데이트: n e w est : 6, w i d est : 3
- 이어서 l + o (7회) -> lo, lo + w (7회) -> low 순으로 병합 진행.
5단계: 설정한 어휘 사전 크기(Vocabulary Size)에 도달할 때까지 반복
3. 추론(Inference / Tokenization) 과정
학습을 통해 병합 규칙(Merge Rules)과 어휘 사전이 완성되면, 새로운 단어가 들어왔을 때 다음과 같이 토큰화합니다.
- 사전에 있는 단어: lowest가 입력된 경우
- 먼저 글자 단위로 쪼갬: l, o, w, e, s, t
- 학습했던 병합 규칙을 순서대로 적용: low + est
- 최종 토큰: ['low', 'est']
- 사전에 없는 생소한 단어 (OOV 방지): high-est나 structuralest 같은 단어가 들어와도 이미 학습된 서브워드인 est 단위로 안전하게 쪼개어 연산할 수 있게 됩니다.
4. BPE의 주요 장점과 특징
- OOV(Out-Of-Vocabulary) 완벽 배제
- 아무리 신조어나 오탈자가 들어와도 최악의 경우 문자(Character) 단위까지 쪼개서 처리할 수 있으므로 [UNK] 오류가 발생하지 않습니다.
- 어휘 사전 크기(Vocabulary Size)의 효율적 관리
- 하이퍼파라미터로 사전 크기(예: 32,000개, 50,000개 등)를 직접 지정할 수 있어 메모리 효율성과 모델 성능 간의 트레이드오프를 조절하기 쉽습니다.
- 다국어(Multilingual) 처리의 용이성
- 구글 번역기처럼 여러 언어를 하나의 모델로 처리할 때, 각 언어의 공통 서브워드나 알파벳/문자를 하나의 통합 어휘 사전으로 효율적으로 관리할 수 있습니다.
4. 모델 개발 및 트레이드오프 (Model Architecture)
📌 1) 모델 구조
인코더와 디코더 각각의 세부 구성 요소입니다.
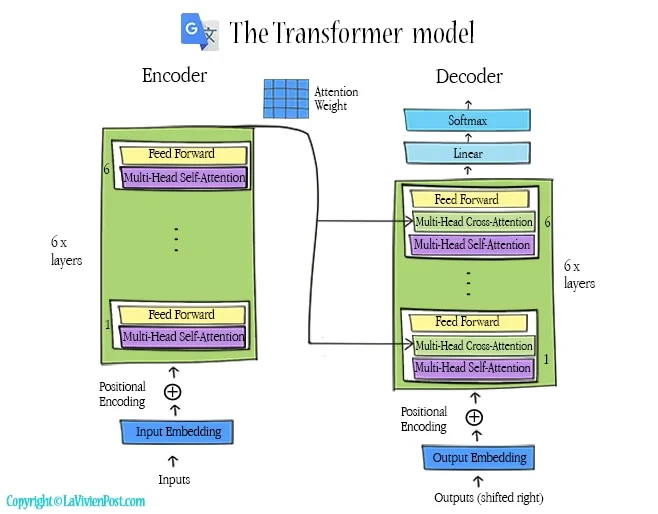
- 인코더 (Encoder)
- 텍스트 임베딩 (Text Embedding): 입력 토큰을 고차원 벡터로 변환.
- 위치 인코딩 (Positional Encoding): 단어의 순서 및 위치 정보를 벡터에 주입.
- 트랜스포머 (Transformer Layer): Self-Attention을 통해 소스 문맥을 풍부하게 압축 representation 생성.
- 디코더 (Decoder)
- 텍스트 임베딩 (Text Embedding): 타깃 언어 토큰 벡터화.
- 위치 인코딩 (Positional Encoding): 타깃 단어의 위치 정보 주입.
- 트랜스포머 (Transformer Layer): Masked Self-Attention 및 인코더와의 Cross-Attention 수행.
- 예측 헤드 (Prediction Head): 최종 어휘 사전 확률 분포를 계산하여 다음 토큰 예측.
더보기💡 인코더(Encoder)와 디코더(Decoder)의 주요 차이점 3가지
인코더와 디코더는 둘 다 트랜스포머 기반의 아키텍처이지만, "입력을 이해(압축)하는 역할"과 "출력을 생성하는 역할"이 서로 다르기 때문에 내부 구조에서 명확한 차이가 발생합니다.
1. 교차 어텐션 계층 (Cross-Attention Layer)
- 인코더에는 없고, 디코더에만 존재합니다.
- 인코더: 입력 문장 내부의 관계만 파악하면 되므로 교차 어텐션이 필요 없습니다.
- 디코더: 타깃 언어로 단어를 생성할 때, "인코더가 넘겨준 원문 정보 중 어느 단어를 집중해서 참조해야 하는가?"를 판단해야 합니다. 따라서 인코더의 출력을 다이나믹하게 참조하는 교차 어텐션 계층이 필수적으로 포함됩니다.
2. 셀프 어텐션 메커니즘 (Self-Attention Mechanism)
- 인코더는 양방향(Bidirectional), 디코더는 마스크드(Masked) 방식을 사용합니다.
- 인코더 (양방향 셀프 어텐션): 입력 문장 전체가 한 번에 주어지므로, 문장 내의 모든 단어가 앞뒤 전체 문맥을 자유롭게 참조하여 의미를 파악합니다.
- 디코더 (마스크드 셀프 어텐션): 텍스트를 한 번에 토큰 하나씩 순차적(Autoregressive)으로 생성합니다. 따라서 아직 생성되지 않은 미래의 단어(Right-side context)를 미리 들여다보지 못하도록 마스킹(Masking) 처리된 셀프 어텐션을 사용합니다.
3. 예측 헤드 (Prediction Head)
- 인코더에는 없고, 디코더의 맨 마지막에 위치합니다.
- 인코더: 소스 문장을 고차원 벡터(컨텍스트 표현)로 변환하는 것이 목적이므로 final 분류기(Head)가 필요 없습니다.
- 디코더: 최종 목표가 "다음 단어로 어떤 토큰이 올지 예측하는 것"입니다. 따라서 디코더의 마지막 레이어에는 수만 개의 단어 사전(Vocabulary) 중 어떤 단어가 올지 확률 분포를 계산하는 선형 레이어(Linear) 및 소프트맥스(Softmax) 기반의 예측 헤드가 결합되어 있습니다.
📌 2) 학습 (Training)
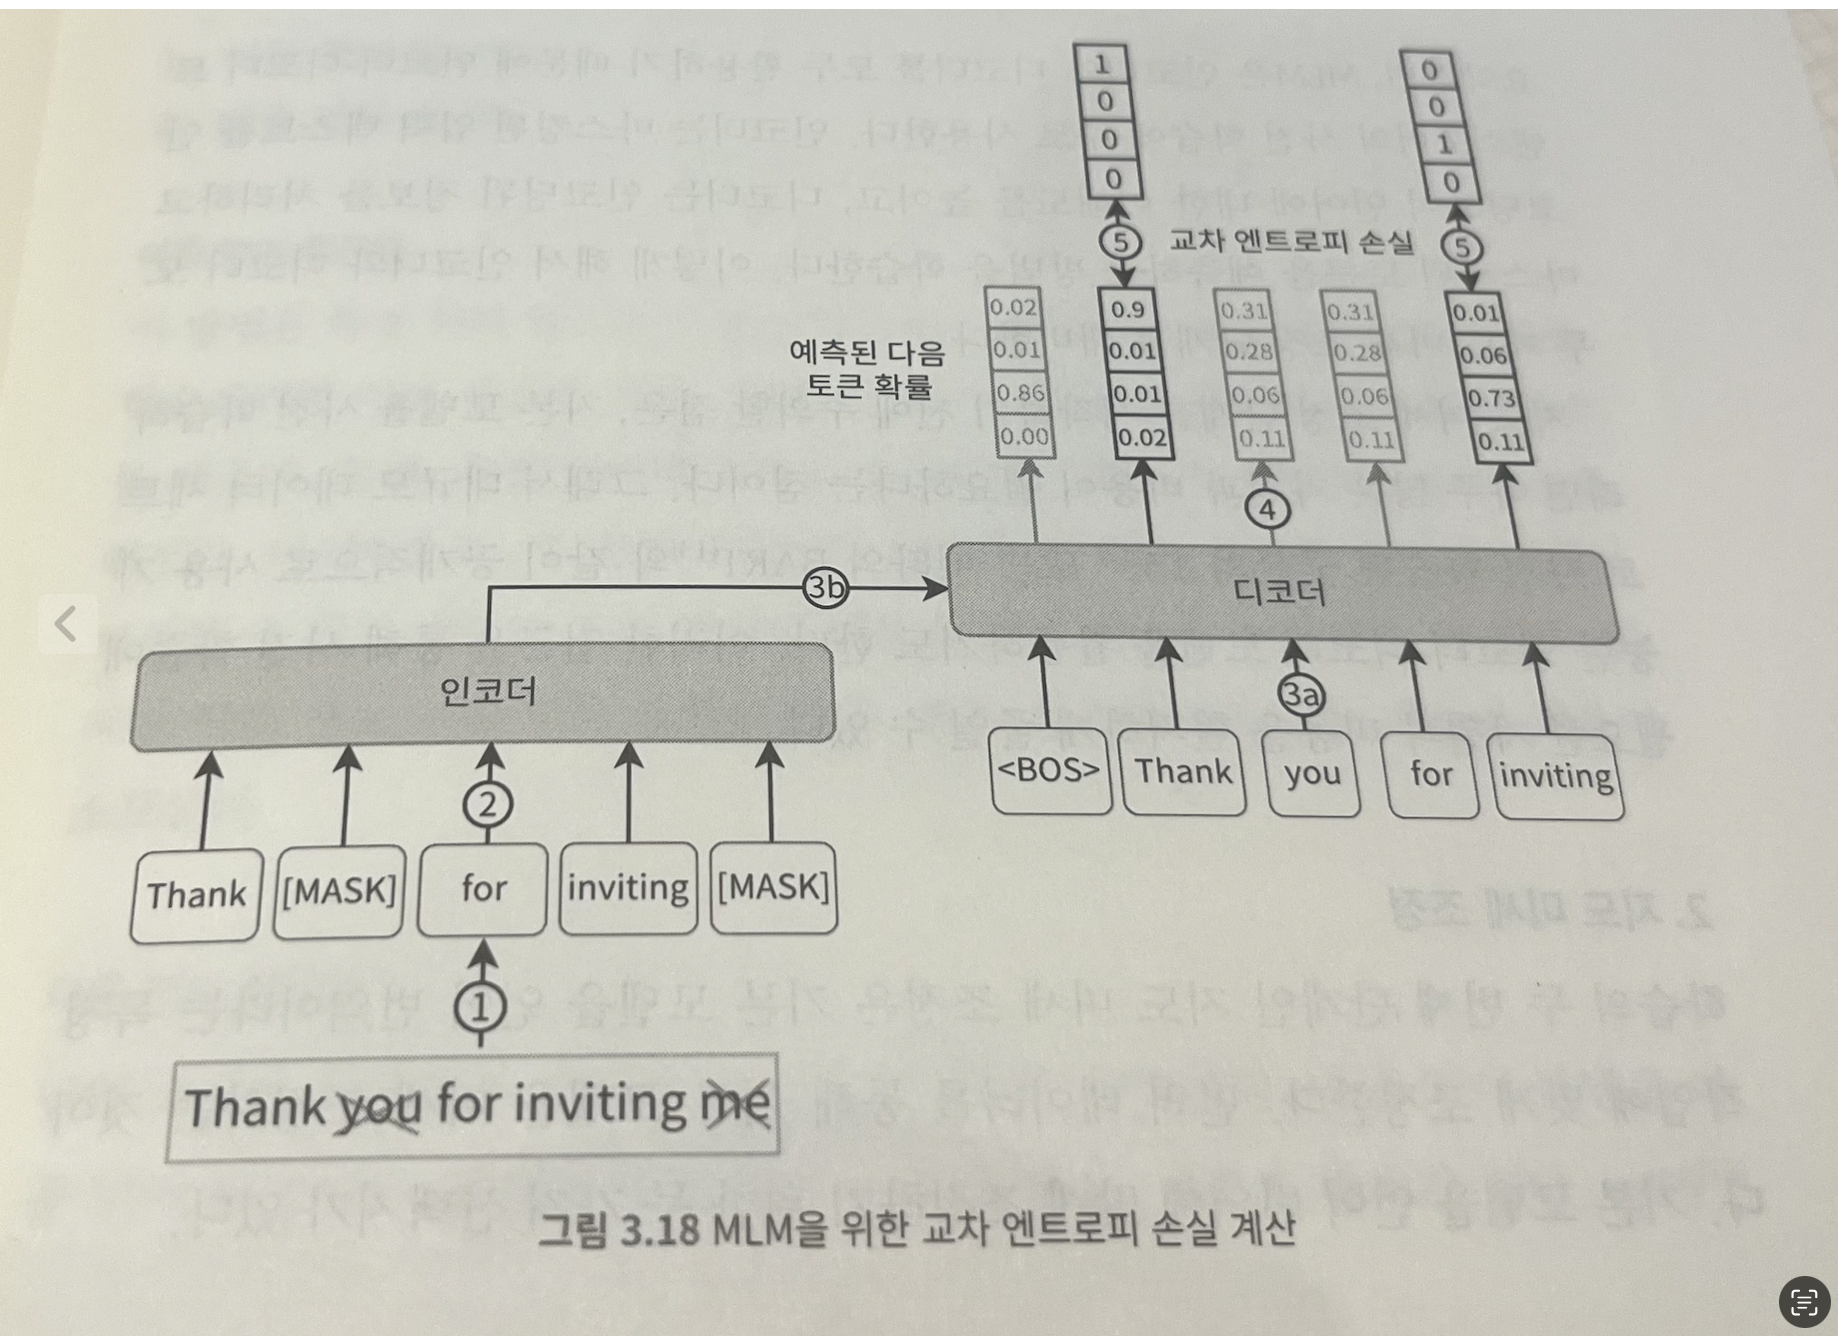
- 비지도 사전 학습 (Unsupervised Pre-training):
- 일반 텍스트 데이터: 라벨이 없는 대규모 단일 언어 코퍼스 활용.
- MLM (Masked Language Modeling) 학습 방식:
- 인코더 입력: 문장 내 일부 단어를 [MASK] 처리하여 전달. 인코더는 앞뒤 양방향 문맥을 쥐어짜내어 문맥 벡터를 생성하도록 훈련.
- 디코더 입력: 디코더에는 [인코더의 마스킹 문맥 벡터]와 [원본 문장의 이전 토큰 시퀀스] 2가지가 함께 입력.
- 손실 계산: 디코더는 두 입력 힌트를 교차 어텐션으로 조합하여 [MASK] 위치의 단어(또는 다음 단어)를 예측하고, 교차 엔트로피 손실(Cross-Entropy Loss)을 계산해 모델 전체를 업데이트.
- MLM의 장점: 단순 다음 단어 예측(Causal) 방식과 달리 양방향 문맥을 훑어보므로, 인코더의 문맥 이해 및 텍스트 표현(Representation) 능력이 극대화됨.
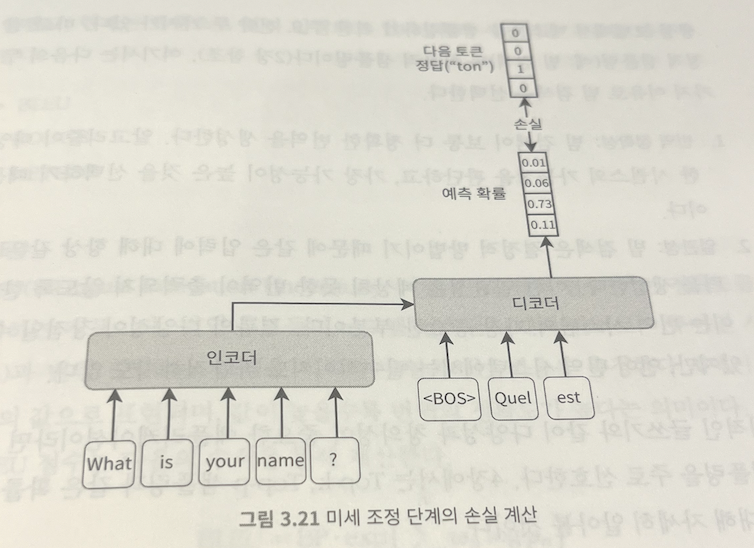
- 지도 미세 조정 (Supervised Fine-tuning):
- 이중 언어 접근법 (Bilingual Approach): 특정 두 언어 쌍(Pair) 데이터로 최적화.
- 다중 언어 접근법 (Multilingual Approach): 하나의 모델에 여러 언어 데이터셋을 함께 학습시켜 저자원 언어 성능 및 효율성 확보.
📌 3) 샘플링 (Sampling)
- 빔 검색 (Beam Search): 디코딩 시 단순 탐욕적(Greedy) 선택 대신, 상위 K개의 유력한 후보 시퀀스를 유지하며 최적의 번역 결과 탐색.
5. 오프라인 & 온라인 평가 (Evaluation Metrics)
📌 오프라인 평가 (Offline Evaluation)
학습된 모델을 실제 서비스에 배포하기 전, 구축해 둔 정답 데이터셋(테스트 세트)을 활용해 수학적·통계적으로 번역 품질을 평가하는 방식입니다.
- BLEU (Bilingual Evaluation Understudy)
- 개념: 정답 번역문과 모델 번역문 간의 N-gram(1~4개 단어 조합) 정합도(Precision)를 측정하는 기계 번역의 대표 지표.
- 특징: 짧은 문장을 남발하여 정합도를 억지로 높이는 것을 방지하기 위해 길이 페널티(Brevity Penalty)를 적용.
- ROUGE (Recall-Oriented Understudy for Gisting Evaluation)
- 개념: 정답 번역문에 있는 단어가 모델 번역문에 얼마나 포함되었는지 재현율(Recall) 중심으로 측정하는 지표.
- 특징: 주로 요약(Summarization) 평가에 많이 쓰이지만, 번역 시 정답 문장의 핵심 내용이 빠짐없이 들어갔는지 확인할 때도 활용.
- METEOR (Metric for Evaluation of Translation with Explicit ORdering)
- 개념: 단순 단어 일치를 넘어 동의어(Synonym), 어근(Stemming) 일치, 단어 순서(Word Order)까지 고려하여 평가하는 지표.
- 특징: BLEU가 완전히 똑같은 단어만 카운트하여 사람의 실제 직관과 다를 수 있는 한계를 보완.
📌 온라인 평가 (Online Evaluation)
모델을 실제 서비스 환경에 배포한 후, 실제 사용자의 행동 패턴과 피드백 데이터를 실시간으로 모니터링하여 평가하는 방식입니다.
- 사용자 피드백 (User Feedback)
- 개념: 사용자가 번역 결과를 사용하면서 남기는 직접적/간접적 반응 데이터.
- 측정 항목: 번역문 '좋아요/나빠요' 클릭, 사용자의 번역문 수정을 위한 재편집(Edit) 비율, 번역 결과 복사 및 공유 횟수 등.
- 사용자 참여도 (User Engagement)
- 개념: 서비스 전체의 건강도와 사용자의 지속적 이용 여부를 측정하는 비즈니스 지표.
- 측정 항목: 일일/월간 활성 사용자 수(DAU/MAU), 서비스 재방문율, 세션당 평균 번역 요청 횟수 등.
6. 전체 시스템 아키텍처 설계 (System Architecture)
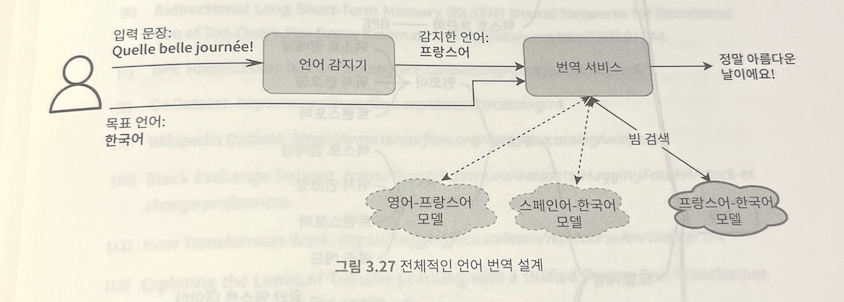
📌 언어 감지기
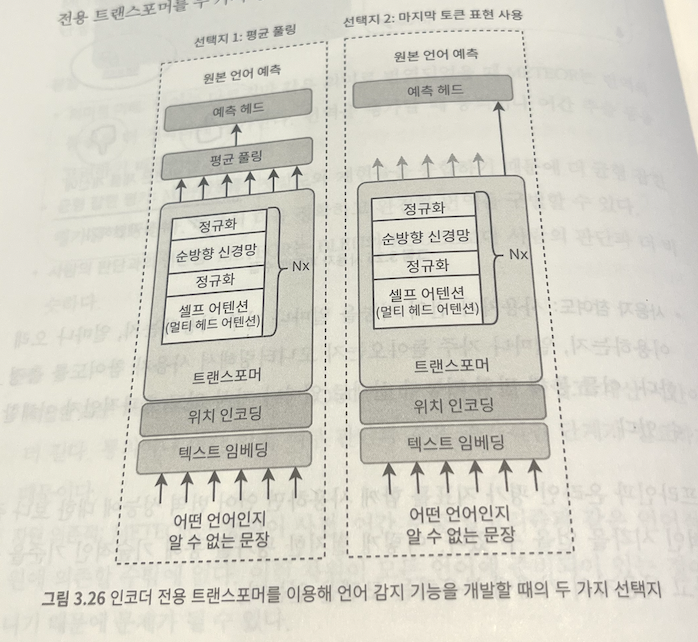
- 평균 풀링
- 마지막 토큰 표현
'스터디' 카테고리의 다른 글
[가상 면접 사례로 배우는 생성형 AI 서비스 설계] 6장: 검색 증강 생성 (0) 2026.09.20 [Kotlin in Action: 2/e] 17장 (0) 2026.07.25 [Kotlin in Action: 2/e] 14장 (0) 2026.06.28 [Kotlin in Action: 2/e] 13장 (0) 2026.06.20 [Kotlin in Action: 2/e] 9장 (0) 2026.05.24